Вы услышали про «локального ИИ-агента» - такого, который работает на вашем железе, а не в чужом облаке, и подумали: может, это про меня. Чаще всего повод один - данные, которые по правилам компании или по закону нельзя отдавать наружу. Это персональные данные клиентов, переписка, документы, чужая коммерческая тайна у вас на подряде. Или наоборот, поток запросов такой большой и ровный, что облачный счёт за каждый вызов начинает кусаться. Отвечу коротко, а дальше разберу по частям.
Локальный ИИ-агент - это агент, у которого и языковая модель, и данные остаются на вашем оборудовании, не уходя на чужие серверы. Собирается он из трёх частей: раннёр, который запускает модель прямо у вас, открытая модель и оркестратор с инструментами. Всё это реально и ставится без фокусов. Но локальное - это обмен, выигрыша сам по себе он не даёт. Вы получаете контроль над данными. Взамен берёте на себя своё железо, своё обслуживание и, как правило, модель слабее лучших облачных.
Я собираю агентов под конкретные дыры в бизнесе и к вопросу «локально или в облаке» отношусь как к развилке с ценой, а не как к модному слову. Эта статья - про то, из чего локальный агент собран и на каком железе живёт. И как понять, ваш ли это случай, чтобы вы не заплатили за «секретность» и не остались с медленной игрушкой.
Если вы ещё не держали в руках, из чего состоит агент и какие решения владелец принимает до кода, начните с разбора «Создание ИИ-агента». Здесь я опираюсь на него и говорю только про то, что меняет слово «локальный».
Что значит «локальный» и чем он отличается от облачного
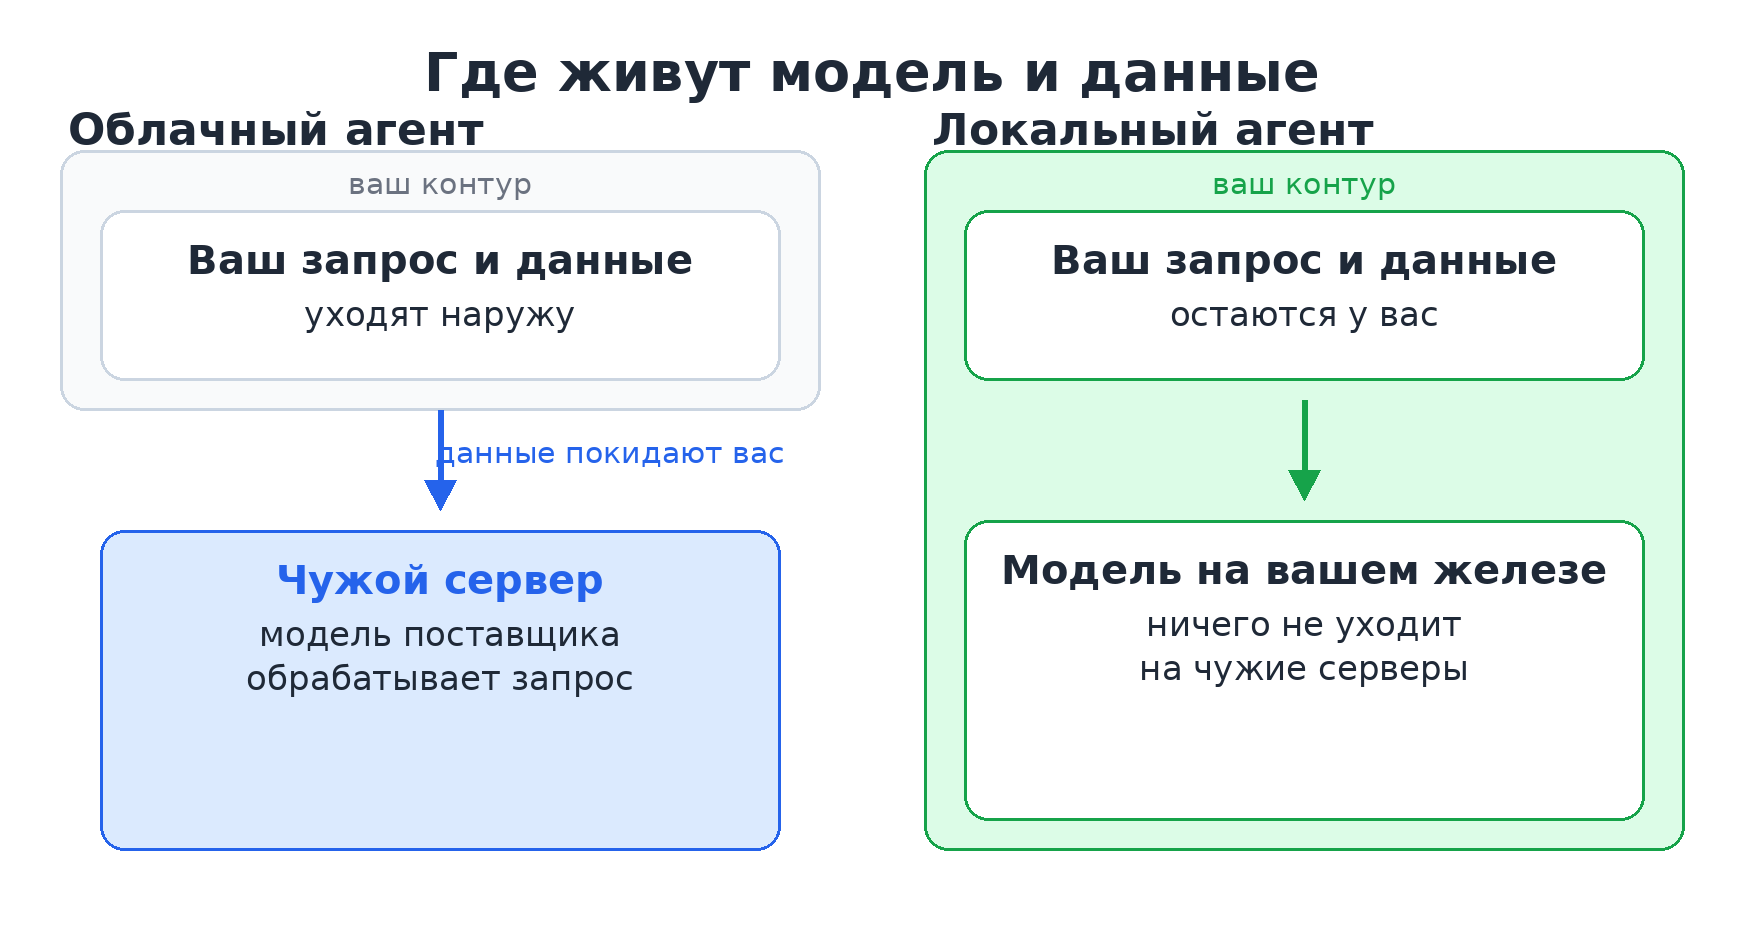
Разница между локальным и облачным агентом - в одном вопросе: где физически живут модель и ваши данные. У облачного агента запрос уходит на сервер поставщика, там модель его обрабатывает и возвращает ответ. Данные в этот момент покидают ваш контур. У локального агента модель запущена на вашем компьютере или сервере, и запрос никуда не уходит.
Это не теория. Раннёр Ollama прямо так и описывает локальный режим: «Download Ollama and run a model on your computer». По-русски: скачайте Ollama и запустите модель на своём компьютере. Оркестратор n8n, через который дают агенту инструменты, тоже ставится на своё железо. В документации так и сказано: «You can self-host n8n on your own infrastructure, on-premises, or in a private cloud». По-русски: n8n можно разместить самостоятельно на своей инфраструктуре, локально или в частном облаке.
Сложите одно с другим - и получается агент, у которого и мозг, и инструменты, и данные остаются у вас. Отсюда главное свойство: ничего не уходит на чужие серверы. Это свойство размещения. Юридической гарантии, что вы соблюли закон, оно не даёт - но именно оно решает задачу, когда данные по правилам нельзя выпускать наружу.
Чем за это платят, видно сразу. Облачный агент не требует от вас ни видеокарты, ни администрирования: поставщик держит железо и обновляет модель. Локальный перекладывает это на вас. Разложу развилку на схеме.
Где собирать агента в принципе - в облачном сервисе или в самостоятельном размещении - я разбираю отдельно в статье «Платформа для создания ИИ-агентов». Здесь же мы берём именно тот случай, где всё держится на вашей стороне.
Когда локальный агент оправдан
Локальное имеет смысл не «для надёжности вообще», а в трёх понятных случаях. Если ни один из них не ваш, скорее всего, вам нужен не локальный агент.
Данные нельзя отдавать наружу. Это самый частый честный повод. Персональные данные клиентов, медицинские сведения, материалы юридической практики, чужая коммерческая тайна, которую вам доверили на подряде. Когда правило простое - «эти данные не покидают наш контур», - локальный агент становится условием задачи. Он обрабатывает их там же, где они лежат.
Нет стабильного интернета или он запрещён. Производство, закрытый контур, объект без внешней сети. Облачный агент там просто не работает: нет канала до сервера поставщика. Локальный работает, потому что ему канал не нужен.
Поток запросов большой и постоянный. В облаке вы платите за каждый вызов. Пока обращений немного, это дёшево и удобно. Когда их тысячи в день изо дня в день, счёт за каждый запрос складывается в заметную сумму, и своё железо, купленное один раз, может оказаться дешевле на дистанции. Это надо считать на ваших числах, а не принимать на веру: малый и неровный поток почти всегда дешевле держать в облаке.
Заметьте, чего в этом списке нет. Нет пункта «локальное безопаснее само по себе». Безопасность даёт не место, где крутится модель, а то, как настроены доступы, кто администрирует сервер и как вы проверяете результат. Плохо настроенный локальный агент опаснее аккуратного облачного. К этому вернёмся в разделе про ошибки.
Не уверены, ваш ли это случай? С этого вопроса я и начинаю разбор. Оставьте четыре ответа о вашем деле - в карте автоматизации отмечу, где локальное правда нужно, а где это лишняя трата.
Из чего собран локальный агент
Локальный агент собран из трёх частей, и все три живут на вашем оборудовании. Устройство самого агента - модель с инструментами, памятью и заданием, работающая в цикле - то же, что у любого другого; я разбирал его в отдельной статье. Слово «локальный» меняет только то, где каждая часть запущена.
Первая часть - раннёр. Это программа, которая запускает языковую модель прямо у вас. Проще всего взять Ollama. Он предлагает начинать с открытых моделей: «Start building with open models». И даёт для них REST API: «Ollama has a REST API for running and managing models». То есть к модели обращаются ваш код и инструменты через обычный интерфейс. Второй распространённый раннёр - llama.cpp. Его цель описана так: «inference with minimal setup and state-of-the-art performance on a wide range of hardware - locally and in the cloud». По-русски: запуск моделей с минимальной настройкой на самом разном железе, локально и в облаке.
Вторая часть - открытая модель. Облачные флагманы вы к себе не поставите: они закрыты и живут на серверах поставщика. Локально работают открытые модели, которые можно скачать и запустить у себя. Их много, они разного размера, и выбор тут не «какая самая умная», а «какая влезет в ваше железо и справится с вашей задачей». Конкретную модель я не называю лучшей: они обновляются, и честно проверять надо на своих примерах, а не по чужому рейтингу.
Третья часть - оркестратор с инструментами. Модель сама по себе только пишет текст. Чтобы она читала заявки, писала в таблицу или дёргала ваш сайт, ей нужны инструменты и то, что связывает их в рабочий процесс. Для этого удобен n8n в самостоятельном размещении. Без лицензионного ключа он работает как бесплатная Community-редакция: «Without a license key, n8n runs as the free Community edition». А для быстрого старта есть готовый набор: «n8n's curated self-hosted AI Starter Kit». Инструменты - это доступ к инструменту. Давать их надо ровно столько, сколько нужно под одну задачу, и ни одним больше.
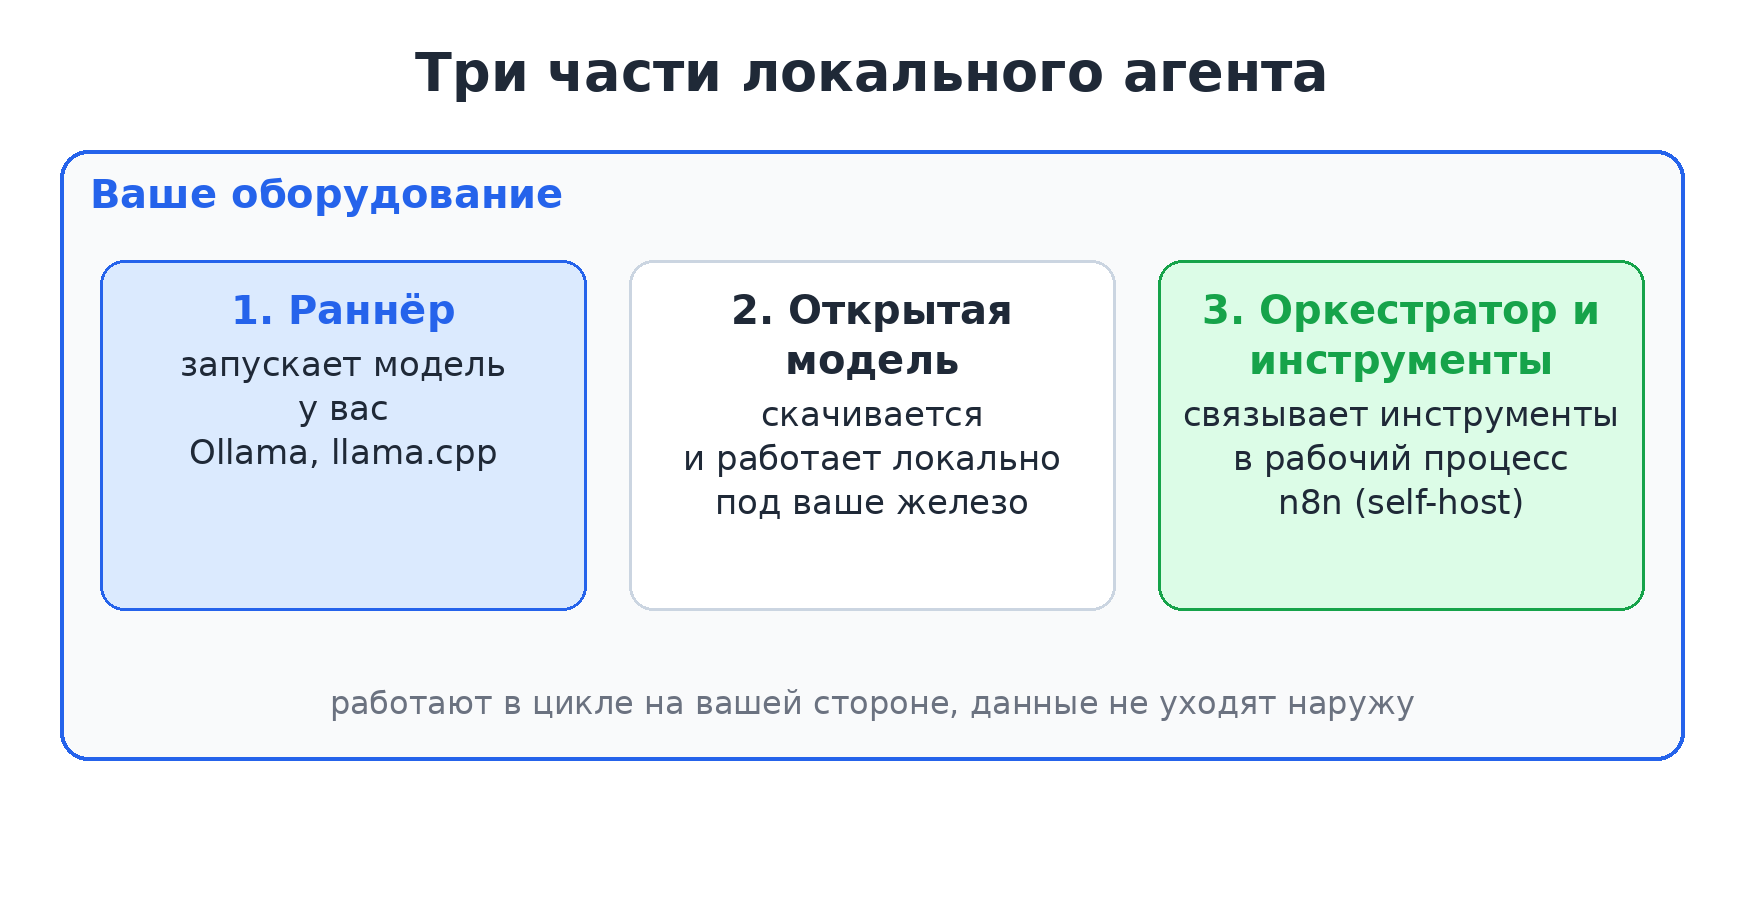
Ни одна из трёх частей не требует от вас писать модель с нуля. Требует порядка: установить раннёр, выбрать модель под железо и аккуратно собрать инструменты. Дальше - вопрос, на чём всё это поедет.
На каком железе это работает
Это главный вопрос, на котором чаще всего и рушатся ожидания. Ответ честный: зависит от размера модели, и двух одинаковых случаев не бывает.
Запустить что-то можно и на обычном процессоре, без видеокарты. llama.cpp рассчитан на самое разное железо, не только на мощные видеокарты. Маленькая модель ответит и на ноутбуке, просто медленнее.
Чем крупнее модель, тем больше ей нужно памяти. Большие модели целиком живут на видеокарте, и её объём становится потолком. Два приёма помогают его отодвинуть. Первый - квантизация: модель хранят в огрублённом виде, и она занимает меньше. llama.cpp поддерживает «integer quantization for faster inference and reduced memory use» - целочисленную квантизацию ради ускорения и меньшего расхода памяти, от 1,5 до 8 бит. Второй приём - гибридный расчёт. llama.cpp умеет «CPU+GPU hybrid inference to partially accelerate models larger than the total VRAM capacity». По-русски: частичное ускорение на связке процессор плюс видеокарта для моделей крупнее, чем помещается в видеопамять.
Что это значит для вас на человеческом языке:
- маленькая модель под узкую задачу - может хватить мощного ноутбука или обычного сервера без отдельной видеокарты;
- модель побольше, чтобы отвечала живее и умнее, - нужна видеокарта с достаточной памятью;
- совсем большая модель - либо дорогая видеокарта, либо квантизация и гибридный расчёт ценой скорости и части качества.
Конкретные гигабайты и модели видеокарт я намеренно не называю: они зависят от выбранной модели и быстро устаревают. Правильный порядок - сначала выбрать самую маленькую модель, которая решает вашу задачу, и уже под неё считать железо, а не наоборот.
С чего начать: шаги проверки
Соблазн - сразу купить сервер с видеокартой и «развернуть ИИ». Порядок, который бережёт деньги, обратный: сначала проверить на малом, потом докупать железо.
- Проверьте повод. Данные правда нельзя отдавать в облако, или это «на всякий случай»? Нет жёсткого запрета и большого потока - локальное, скорее всего, лишняя трата, остановитесь здесь.
- Поставьте раннёр на то, что есть под рукой. Ollama ставится одной командой:
curl -fsSL https://ollama.com/install.sh | sh- Возьмите маленькую открытую модель и прогоните на ней десяток своих реальных случаев. Смотрите не на один красивый ответ, а на то, стабильно ли она попадает раз за разом.
- Если качества на маленькой модели не хватает, прикиньте модель побольше и уже под неё считайте видеопамять. Станет ясно, во что обойдётся железо, ещё до покупки.
- Когда модель выбрана, подключите инструменты и соберите рабочий процесс - например, в самостоятельном n8n. Доступы давайте по одному, под конкретное действие.
- Оставьте приёмку и условие остановки такими же, как у облачного агента: эталон для проверки результата и точка, где агент зовёт человека.
Шаги 2-5 делайте на тестовых, а не на боевых данных и аккаунтах, пока не убедитесь, что агент ведёт себя предсказуемо.
Этот порядок я держу и на платных задачах: сначала самая простая проверка на малом, и только потом вложения. Из чего складывается цена, когда за сборку берётся подрядчик, я разбираю в статье «Внедрение ИИ под ключ».
Где облако честнее и когда локальный не нужен
Продавец «секретной коробки» об этом не расскажет, но честный итог часто такой: вам не нужен локальный агент. Облако выигрывает в трёх вещах.
Во-первых, сила модели. Лучшие модели закрыты и доступны только в облаке; открытые, которые вы запустите у себя, как правило, слабее. Для многих задач разница решающая. Инженеры Anthropic советуют не гнаться за сложностью: «we recommend finding the simplest solution possible, and only increasing complexity when needed. This might mean not building agentic systems at all». Перевод: берите самое простое решение и наращивайте сложность только по необходимости. Иногда это значит не строить агентскую систему вовсе.
Во-вторых, железо и обслуживание. Облачному агенту не нужна ваша видеокарта. Даже у локальных раннёров есть облачный режим на случай, когда своего железа нет. У Ollama это описано прямо: «Run models without a local GPU». То есть запуск моделей без локальной видеокарты. И Ollama - не «всегда локально»: важно, где именно вы запускаете модель.
В-третьих, деньги на малом потоке. Пока запросов немного, облако дешевле: вы не покупаете и не содержите сервер ради десятка обращений в день. Своё железо окупается только на большом и ровном потоке, и это надо считать по своим числам.
Простое правило: локальное берут, когда дело решают сами данные (их нельзя наружу) или когда поток большой и постоянный. Во всех остальных случаях облако честнее - дешевле, сильнее и без заботы о сервере. А иногда, как я писал в разборе про создание агента, задача и вовсе решается одним аккуратным запросом к модели, и никакой агент не нужен.
Частые ошибки
Самая дорогая ошибка - считать, что «локально» автоматически значит «безопасно и дёшево». И то, и другое надо ещё сделать.
- Купили сервер с видеокартой до проверки на малом. Железо стоит, модель под задачу не выбрана, и часто оказывается, что хватило бы облака. Порядок обратный: сначала проверка, потом вложения.
- Поверили, что локальное безопасно само по себе. Безопасность даёт настройка доступов и администрирование. Место запуска её не добавляет. Открытый наружу локальный сервер - это дыра, а не крепость.
- Открыли агенту лишние доступы «на всякий случай». Это риск, хоть локально, хоть в облаке.
- Проверили агента на одном показе. Один удачный ответ и повторяемость - разные вещи. Это и к облачным относится, но у локальной слабой модели промахи заметнее.
- Забыли приёмку и условие остановки. Модель может выдать выдумку машины - гладкий, но непроверенный ответ. Без эталона и стопа это уходит в дело как факт.
Про накопление ошибок у самостоятельных агентов честно пишут и в Anthropic: «The autonomous nature of agents means higher costs, and the potential for compounding errors». Дальше совет: «We recommend extensive testing in sandboxed environments, along with the appropriate guardrails». По-русски: самостоятельность агента означает рост расходов и риск накопления ошибок, поэтому нужны тщательное тестирование в защищённой среде и ограничители. Локальный запуск этого не отменяет. Полнее про то, что ломается при внедрении и как это увидеть заранее, - в статье «Риски внедрения ИИ-агентов».
Источники
- Ollama. Документация и репозиторий ollama/ollama (открыто 07.10.2026): запуск модели на своём компьютере, работа с открытыми моделями, REST API, облачный режим без локальной видеокарты, команда установки. docs.ollama.com/ и https://github.com/ollama/ollama
- llama.cpp. Репозиторий ggml-org/llama.cpp (открыто 07.10.2026): цель проекта, широкий спектр железа, целочисленная квантизация от 1,5 до 8 бит, гибридный расчёт CPU+GPU для моделей крупнее видеопамяти. github.com/ggml-org/llama.cpp
- n8n. Документация, страница Host n8n (открыто 07.10.2026): самостоятельное размещение на своей инфраструктуре и on-premises, бесплатная Community-редакция без ключа, самостоятельный AI Starter Kit. docs.n8n.io/deploy/host-n8n
- Anthropic. Building Effective AI Agents (инженерный блог): совет брать самое простое решение; рост расходов и накопление ошибок у самостоятельных агентов, тестирование в защищённой среде и ограничители. www.anthropic.com/engineering/building-effective-agents
Хотите не гадать, а понять, нужен ли вам локальный агент или честнее облако? Оставьте четыре ответа о вашем деле - в ответ пришлю карту автоматизации: где машина снимет работу, а где даст пустую цифру.