Каждый день к вам приходят документы: договоры, счета, акты, накладные, первичка от поставщиков. Кто-то в компании вручную переносит из них суммы и реквизиты в учёт, сверяет, раскладывает по папкам. Это та самая рутина, про которую говорят «ИИ её разберёт». Разберёт, но не всю и не молча: если собрать агента неправильно, он поставит в учёт неверную цифру, и вы узнаете об этом из акта сверки через месяц.
Короткий ответ такой. Работа с документом - это две разные задачи. Первая: распознать текст на картинке или скане, превратить изображение в буквы и цифры. Этим занимается OCR-движок. Вторая: понять смысл, найти в тексте нужные поля и разложить их по местам. Этим занимается языковая модель. Отдать машине можно обе, но у каждой своя слабая точка: распознавание ломается на плохой картинке, а модель может выписать значение, которого в документе нет. Поэтому финальную сверку суммы и реквизитов оставляют человеку, а агента собирают так, чтобы каждое поле было видно рядом с тем местом в документе, откуда оно взято.
Я собираю таких агентов под конкретную задачу владельца. Ниже разберу обе задачи по отдельности, покажу, где именно каждая спотыкается, и дам способ собрать проверку, при которой ошибка видна до учёта, а не после. Если хотите сразу понять, какой кусок вашей бумажной рутины реально снимается, это можно разобрать по вашей задаче.
Распознать текст и понять смысл - это две разные задачи
Когда говорят «агент читает документ», внутри почти всегда работают две отдельные ступени, и их полезно различать, потому что ломаются они по-разному.
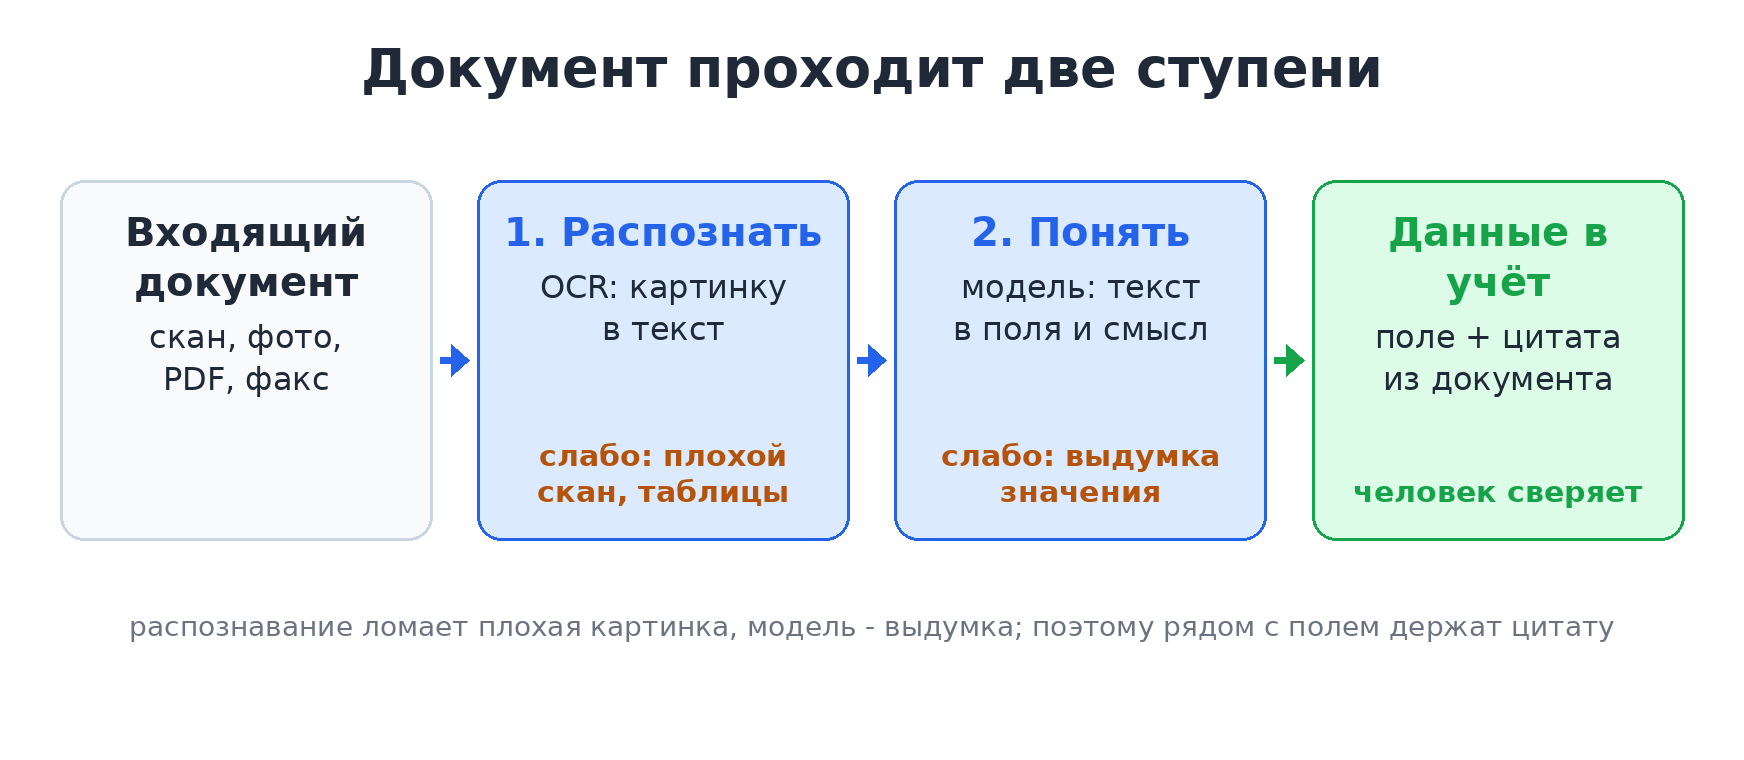
Первая ступень - распознавание, OCR (optical character recognition). Это превращение картинки в текст. Если документ пришёл сканом, фотографией с телефона или факсом, сам по себе он для компьютера просто набор точек. OCR-движок находит на этих точках буквы и цифры и отдаёт их текстом. Один из открытых движков, на котором это видно наглядно, - Tesseract: по описанию проекта это «OCR-движок и программа командной строки», которая распознаёт больше ста языков из коробки. Движков много, есть и облачные, но суть у всех одна: на входе картинка, на выходе текст.
Вторая ступень - понимание. Текст распознан, но это ещё не данные. В строчке «Счёт № 147 от 03.10.2026 на сумму 84 500 руб.» человек сразу видит, где номер, где дата, где сумма. Машине это надо объяснить. Здесь в дело вступает языковая модель. Современные модели читают документ целиком: например, в документации Claude прямо сказано, что модель можно спросить про «любой текст, картинки, графики и таблицы в присланном PDF». Среди заявленных применений - извлечение ключевой информации из юридических документов и перевод сведений из документа в структурированный вид.
Любопытно, что внутри эти две ступени часто живут вместе. По документации обработка PDF у Claude устроена так. Система сначала превращает каждую страницу документа в картинку. Затем с каждой страницы вытаскивается текст и подаётся вместе с картинкой этой же страницы. То есть распознавание и понимание не исключают друг друга, а дополняют: модель видит и буквы, и саму страницу.
Почему это важно вам как владельцу. Если документ изначально цифровой (PDF, выгруженный из системы контрагента, а не снятый на телефон), первая ступень почти не нужна - текст уже чистый, остаётся только понимание. А вот мятый скан с печатью поперёк суммы - это в первую очередь проблема распознавания. Никакая умная модель её не чинит, если на входе каша. Так что вопрос «потянет ли агент мои документы» распадается на два: в каком виде они приходят и что из них нужно достать. Про общий механизм, который виден к концу второй недели работы любого такого агента, я писал отдельно в разборе как работает ИИ-агент.
Что агент реально снимает с документов
Теперь по делу: какую именно работу с входящими документами можно переложить на машину. Я бы выделил три задачи, и все три опираются на то, что модели уже умеют.
Первое - извлечение полей. Это когда из документа надо достать несколько конкретных значений: номер и дату счёта, контрагента, ИНН, сумму, срок оплаты, позиции из накладной. В документации Claude извлечение ключевой информации из документов стоит прямо в списке применений, как и перевод сведений из документа в структурированный вид. На практике это выглядит так: агент получает счёт и возвращает аккуратную строчку с полями, готовую лечь в таблицу или в карточку учёта. Руки, которые раньше перепечатывали это с экрана, освобождаются.
Второе - классификация и раскладка. Пришёл документ - что это: счёт, акт, договор, рекламное письмо? От какого контрагента, к какой сделке относится? Модель справляется с таким разбором, и поток входящих перестаёт быть свалкой: каждый документ едет в свою папку и к своей сделке. Это та же логика, что в разборе ИИ для закупок, где агент разбирает документы поставщиков и отделяет надёжную часть от той, что требует глаз.
Третье - первичная сверка по правилу. Сумма в счёте совпадает с суммой в договоре? Реквизиты поставщика те же, что в карточке? Срок оплаты не просрочен? Это не «умное суждение», а проверка по заранее заданному правилу, и агент выполняет её по каждому документу, не уставая к концу дня. Но сам агент вердикт «платить или нет» не выносит - он лишь подсвечивает расхождение, чтобы человек посмотрел.
Результат распознавания к тому же не обязан быть простынёй текста. Тот же Tesseract, по описанию проекта, отдаёт результат в разных форматах - простой текст, hOCR, PDF с текстовым слоем, TSV. Для автоматизации это значит, что данные из документа можно сразу направить в таблицу или в другую систему, не переписывая вручную.
Где это даёт деньги, видно сразу: там, где поток однотипных документов большой и предсказуемый. Десять счетов в месяц проще обработать руками. Сотни накладных от одних и тех же поставщиков - уже совсем другая история. Хотите понять, сколько в вашем деле уходит на такую рутину и что из неё реально снять? Разберите свою задачу: четыре вопроса, и станет видно, где агент снимет работу, а где принесёт пустую цифру. Смежную рутину в бухгалтерии я разбирал в тексте про нейросети для бухгалтера, а исходящие сводки - в разборе ИИ-агента для отчётов; тут же речь именно про входящий поток.
Где распознавание ломается
Это первая из двух слабых точек, и про неё продавцы «загрузите документ - получите данные» обычно молчат. Распознавание зависит не от ума модели, а от качества картинки на входе. Разработчики Tesseract пишут об этом прямо: во многих случаях, чтобы получить хороший результат, «нужно сначала улучшить качество самой картинки, которую вы даёте движку». Вот конкретные места, где оно спотыкается.
- Низкое разрешение. Tesseract, по документации, лучше всего работает на картинках с разрешением не ниже 300 dpi. Фотография счёта, сделанная на телефон в полумраке склада, этого порога часто не достаёт - и цифры начинают путаться.
- Перекос. Если страницу отсканировали криво, качество распознавания, как сказано в документации, сильно падает: движок хуже делит текст на строки. Пачка документов, брошенная в сканер под углом, - типичный источник ошибок.
- Шум. Пятна, разводы, фон неравной яркости. Часть шума движок убирает сам, но, по документации, не весь, и из-за оставшегося точность может упасть.
- Таблицы. Это известная слабая точка: в документации Tesseract прямо сказано, что без отдельного разбора разметки движок плохо достаёт текст и данные из таблиц. А накладная или спецификация - это как раз таблица.
- Непривычный формат. По умолчанию движок настроен на распознавание предложений из слов, поэтому на чеках, прайсах и кодах его обычно приходится донастраивать - иначе он пытается читать набор артикулов как связный текст.
То же касается языковых моделей, которые читают документ как картинку. Среди рекомендаций в документации Claude есть простое: текст должен быть чётким и читаемым. Рядом совет разворачивать страницы правильной стороной. Рукописные пометки, подписи от руки, печати поперёк текста - всё это по-прежнему тяжёлые случаи для любой системы.
Практический вывод для владельца простой. Если документы приходят в цифровом виде или ровными чёткими сканами, распознавание почти не мешает. Если это фотографии мятых бумаг с печатями, закладывайте, что часть полей машина прочитает неверно, и такие документы должны попадать не сразу в учёт, а на экран человеку. Отказываться от агента тут незачем, достаточно правильно провести границу.
Где агент подставляет значение, которого в документе нет
Вторая слабая точка опаснее первой, потому что её не видно. Когда распознавание ошибается, вы обычно получаете явную кашу: «8Ч 5OO» вместо «84 500». А языковая модель ошибается иначе - уверенно и ровно. Она может выдать аккуратное, правдоподобное значение, которого в документе просто нет.
Это не домыслы, а признанное свойство. В документации Anthropic про снижение галлюцинаций сказано ясно: «даже самые сильные языковые модели иногда выдают текст, который фактически неверен или не соответствует данному контексту». Этот эффект называют галлюцинацией. На документах он выглядит так. Модель видела тысячи счетов и примерно представляет, как счёт устроен. И если в конкретном документе поле неразборчиво или его нет вовсе, она может дописать значение по образцу: правильного вида, но взятое из воздуха.
Представьте, что будет, если такое значение молча уедет в учёт. Неверный ИНН, перепутанная на один знак сумма, подставленный срок оплаты - и всё это выглядит настолько прилично, что сотрудник, листающий сотню карточек, не задержится. Ошибка всплывёт при сверке, в худшем случае - после платежа.
Отсюда железное правило, с которого я начинаю любого такого агента: машине можно доверить достать значение из документа, но не поставить его в учёт без следа, откуда оно взято. Распознать и извлечь - да. Провести сумму как достоверную без возможности быстро свериться с оригиналом - нет. Эта мысль шире документов; я разбирал её в тексте про риски внедрения ИИ-агентов: опасен не тот агент, который иногда ошибается, а тот, чью ошибку не видно.
Как собрать проверку, чтобы ошибку было видно
С выдумкой борются простыми приёмами, и они же описаны в документации. Смысл всех трёх - лишить модель возможности соврать незаметно.
- Разрешить сказать «не знаю». Звучит странно, но помогает сильно: в документации прямо советуют «явно разрешить модели признать неуверенность». Если поле в документе неразборчиво, правильный ответ агента - не красивая цифра, а честное «не распознал, смотрите вручную». Так сомнительные документы сами всплывают наверх.
- Требовать цитату-опору. Под каждое извлечённое значение агент должен привести кусок текста из самого документа, откуда он это взял. Документация описывает это как проверку по цитатам: если модель «не может найти цитату, она обязана снять своё утверждение». На практике рядом с суммой «84 500» стоит вырезка из документа, где эта сумма написана, - и человеку достаточно взгляда, чтобы свериться.
- Запереть в документе. Модель надо прямо инструктировать «брать данные только из присланного документа, а не из общих знаний». Тогда она не имеет права дополнять счёт тем, что «обычно бывает» у таких поставщиков.
Поверх этих трёх приёмов - человек на сверке. Не на всех документах подряд, а на тех, которые агент сам пометил как сомнительные, и на тех, где цена ошибки высока: крупные суммы, новые контрагенты, нетиповые договоры. Остальное идёт потоком, и человек тратит время только на исключения, а не на всю пачку.
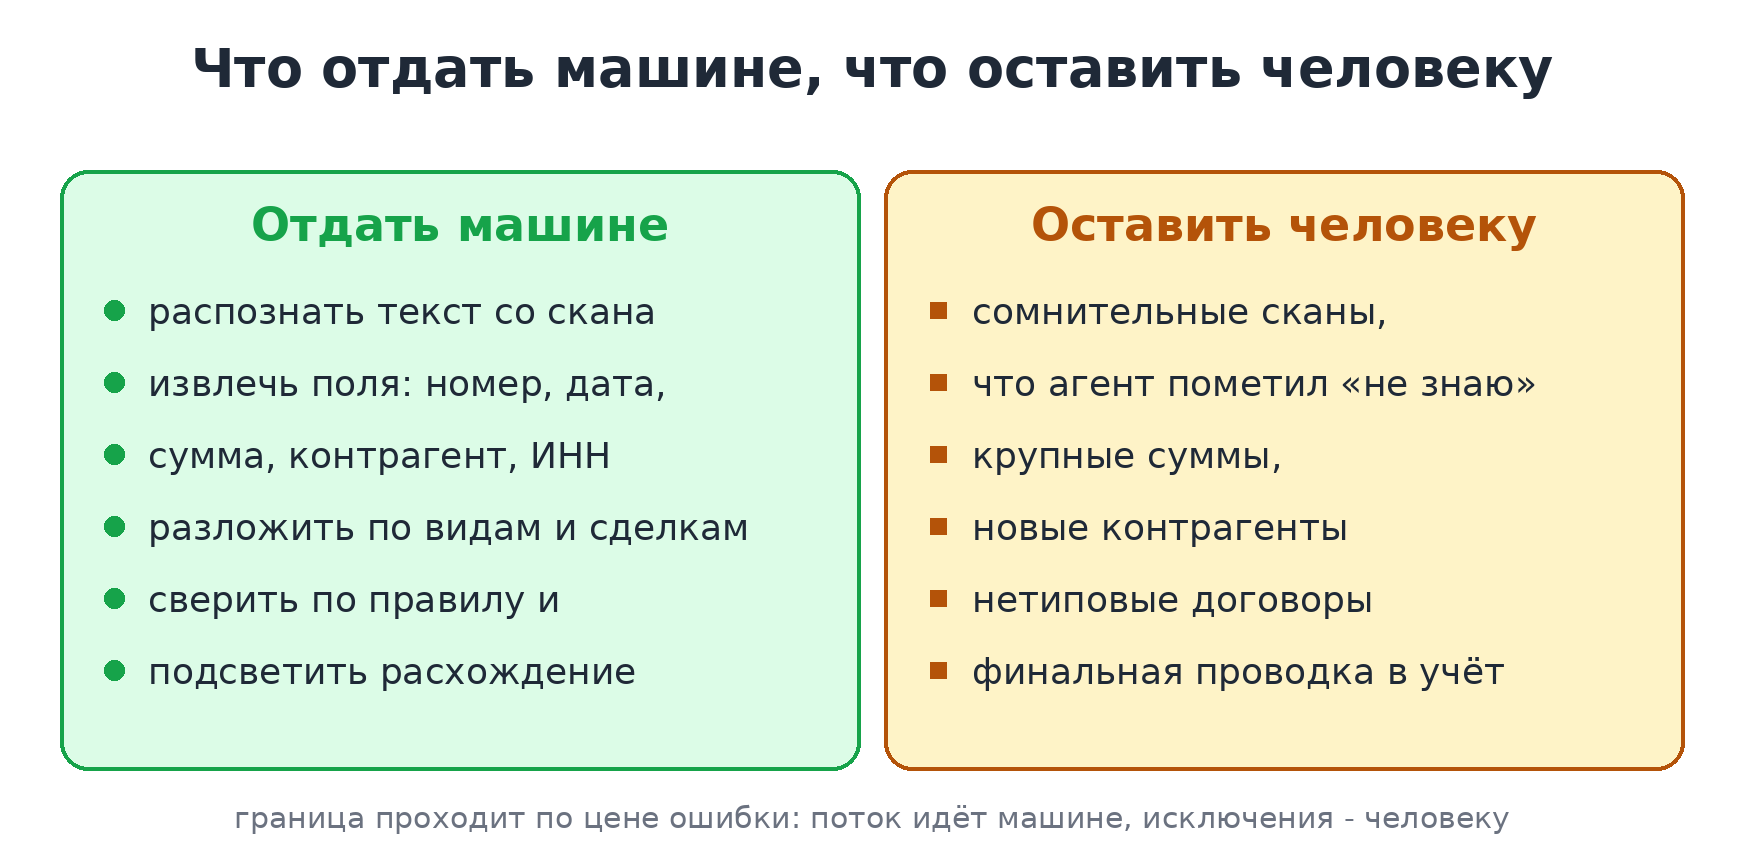
Если собрать агента так, получается не «чёрный ящик, которому мы верим», а помощник, за которым видно каждый шаг. Он снимает механическую часть - распознать, достать, разложить, свериться по правилу - и возвращает человеку только то, что действительно требует решения. Про общее устройство такого агента и четыре решения, которые приходится принять до кода, я писал в разборе создание ИИ-агента.
Когда это не ваш случай и частые ошибки
Агент для документов оправдан не всегда. Вот где я обычно отговариваю.
Поток маленький и редкий. Если документов десяток в месяц, настройка и присмотр за агентом съедят больше, чем вы сэкономите. Руки тут дешевле.
Каждый документ уникален. Агент силён на однотипном потоке: похожие счета, похожие накладные. Если ни один документ не похож на другой и каждый требует юридического чтения, машине не на чем набить руку, и выигрыш тает.
Документы приходят в тяжёлом виде, и исправить это нельзя. Если на входе только мятые фотографии с печатями поперёк цифр, а попросить контрагента присылать нормальный PDF невозможно, большую часть всё равно придётся смотреть глазами - и экономия получается скромной.
Частые ошибки, которые я вижу:
- Верить агенту на слово. Самая дорогая ошибка - пустить извлечённые значения прямо в учёт без цитаты-опоры и сверки. Рано или поздно прилетит аккуратная выдуманная цифра.
- Начинать со всего сразу. Пытаться с первого дня отдать машине все виды документов. Лучше взять один массовый тип - скажем, счета от постоянных поставщиков - довести его до ума, и только потом расширять.
- Гнаться за «полной автоматизацией документооборота». Это красивая обёртка, за которой обычно нет границы между тем, что машина делает надёжно, и тем, что она делает на свой страх. Полезнее снять конкретную дыру, чем купить обещание.
- Мерить успех процентом распознанного, а не делом. Важно не то, какую долю полей агент прочитал, а сколько часов освободилось у людей и сколько ошибок не доехало до учёта.
Я подхожу к этому так же, как к любому внедрению. Сначала смотрим, где именно в вашем потоке теряется время. Выбираем одну дыру и закрываем её, а не ставим «ИИ для документов» ради галочки.
Источники
- Tesseract OCR, README проекта - что такое OCR-движок, поддержка языков и форматов вывода: github.com/tesseract-ocr/tesseract
- Tesseract, Improving the quality of the output - разрешение, перекос, шум, таблицы: tesseract-ocr.github.io/tessdoc/ImproveQuality.html
- Claude Platform Docs, PDF support - чтение документов моделью, механизм и практики: platform.claude.com/docs/en/build-with-claude/pdf-support
- Claude Platform Docs, Reduce hallucinations - выдумка модели и приёмы против неё: platform.claude.com/docs/en/test-and-evaluate/strengthen-guardrails/reduce-hallucinations
Входящие документы - хорошее место, чтобы снять ручную рутину, если правильно развести две задачи и оставить человеку сверку. Хотите увидеть, какой кусок вашей бумажной работы реально снимается, а где агент принесёт пустую цифру, - разберём вашу задачу: четыре вопроса и полминуты.